跳到主要內容

做了個圖片壓縮小工具

· 閱讀需 2 分鍾

寫博客時不可避免要上傳圖片,我現在的圖片都上傳到部署在家裡小主機的minio服務。自己當家才知道財米油鹽貴呀,每一MB空間都會增加備份負擔和流量壓力,動輒數MB的圖片也很考驗服務器帶寬。但其實我並不關注圖片的局部細節,只是想有個花花綠綠的圖而已。

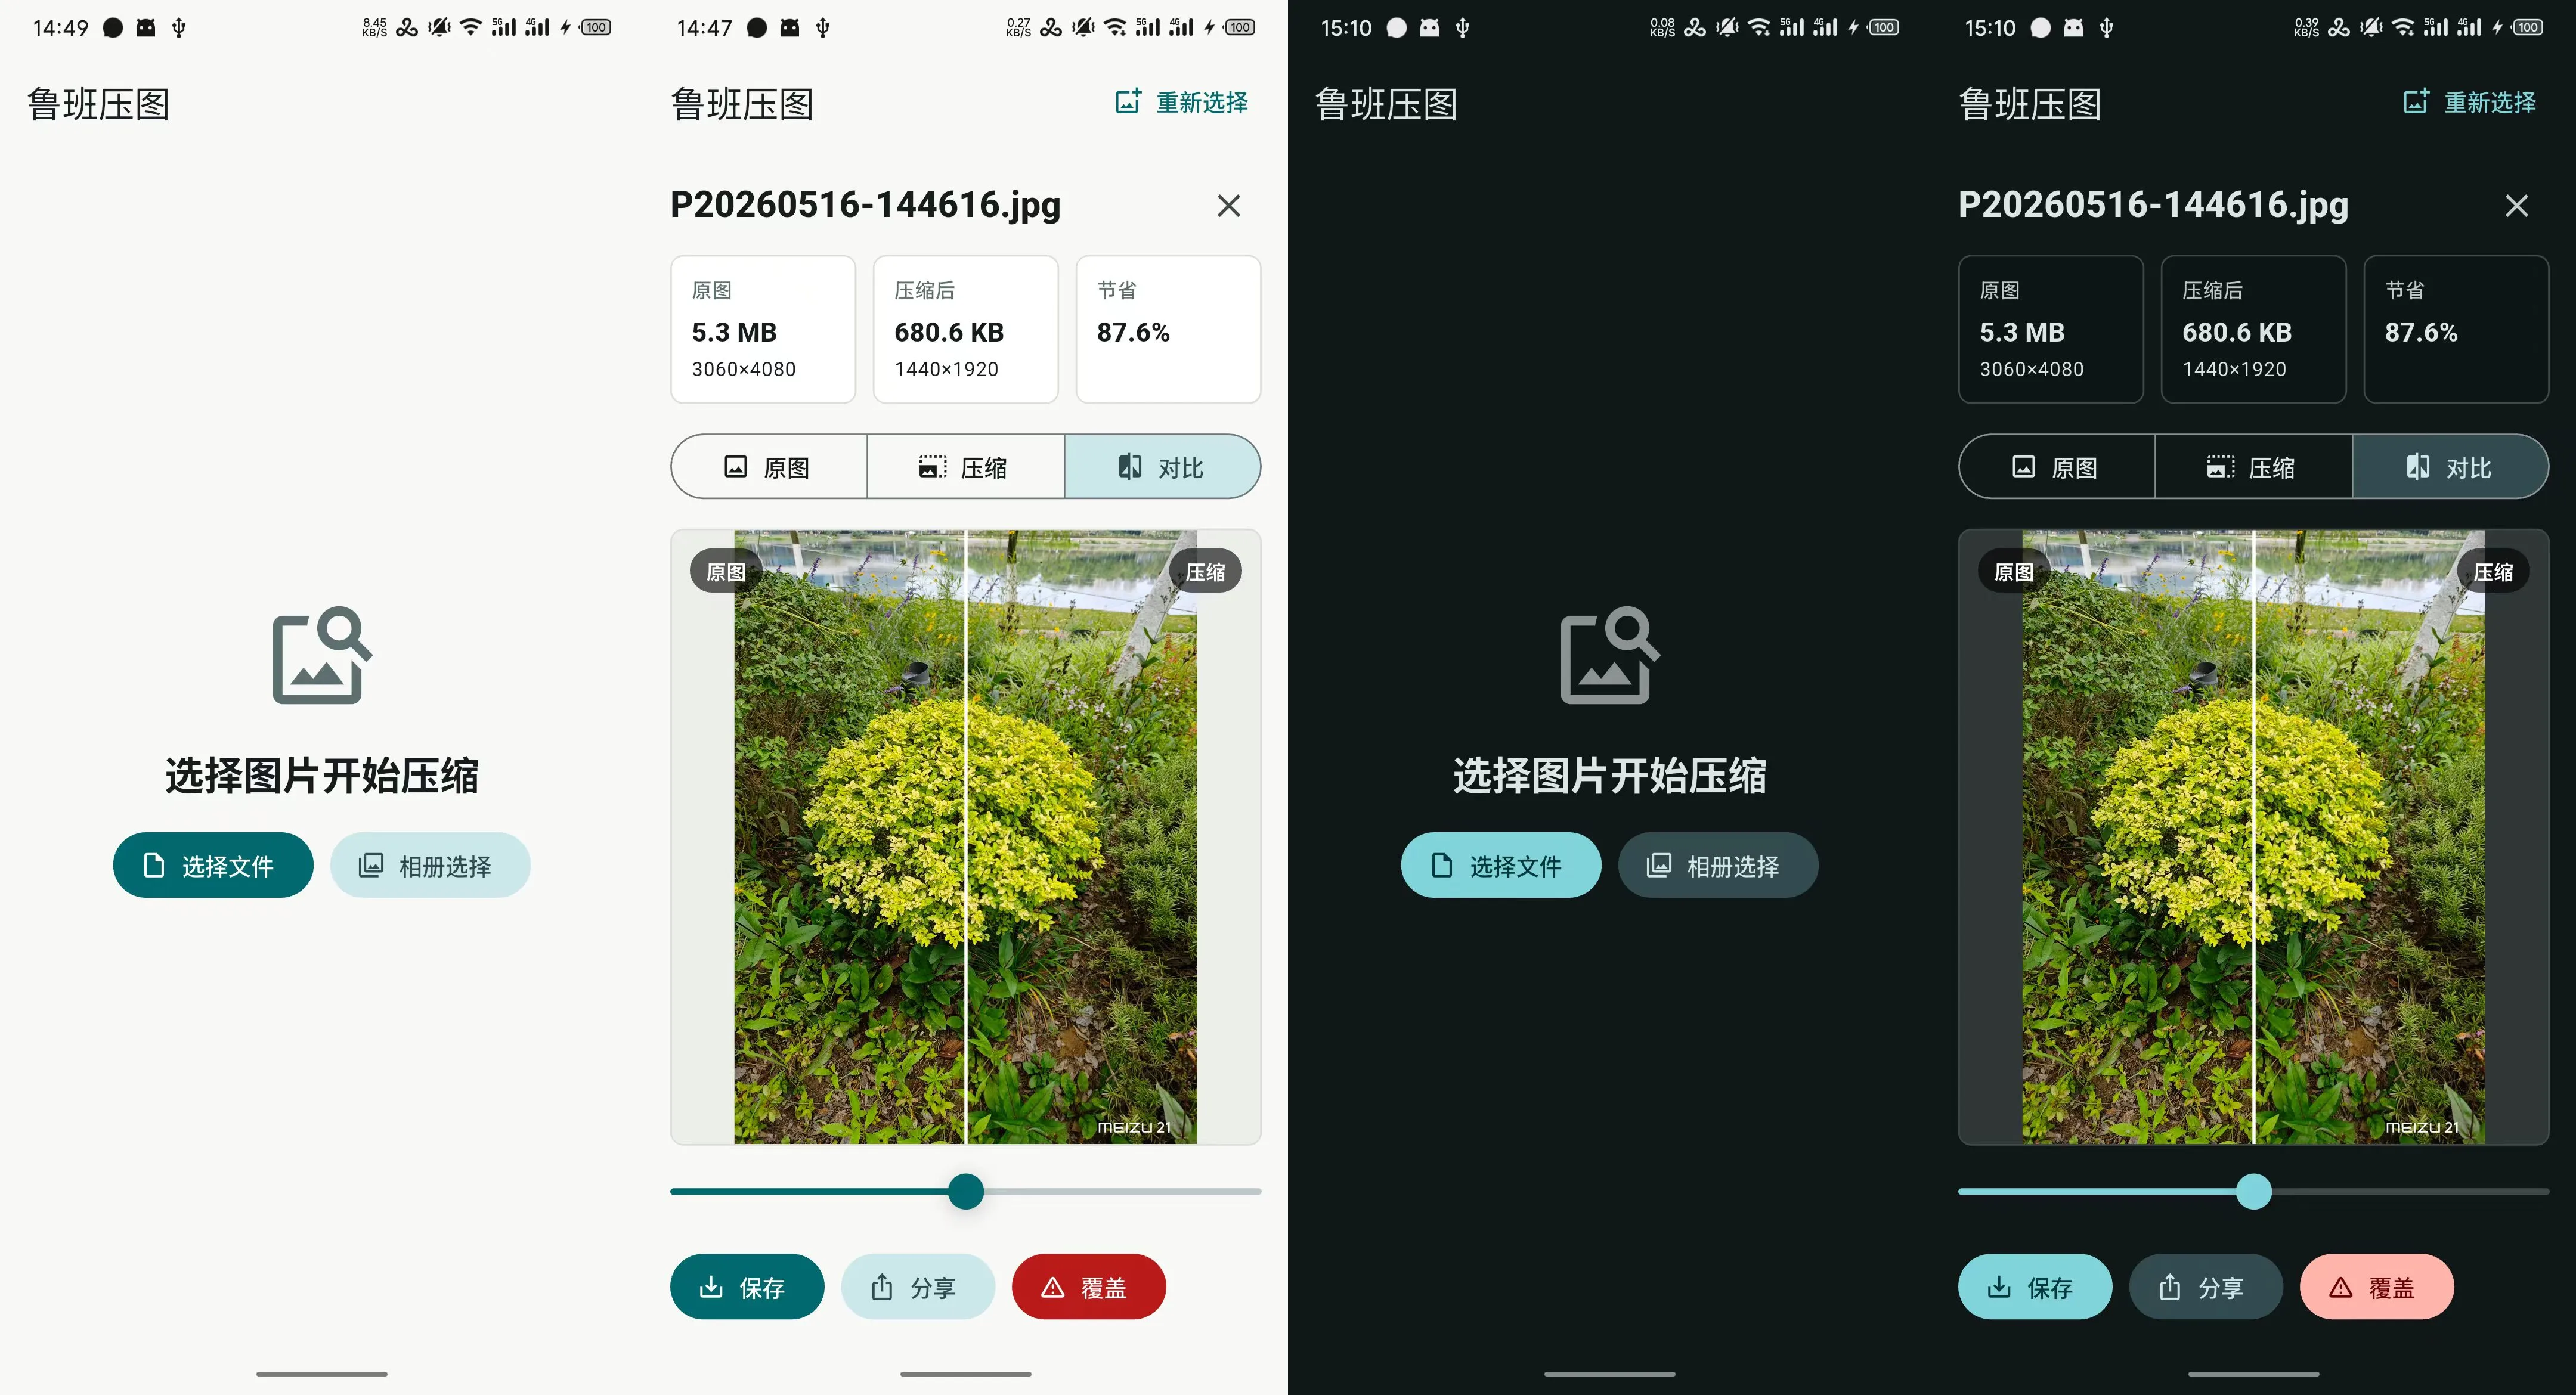
由於我的圖大多都是手機拍的,我希望直接在手機上完成壓縮。找了現存的圖片壓縮app,要麼臃腫肥大參數繁雜,要麼有廣告、訂閱,我只是想把相冊的圖變小一點,僅此而已。

github找了一圈沒有特別對眼緣的,但我找到了Curzibn/Luban,一個模仿微信的智能壓縮庫,很符合我的要求,不用自己調參數,不過它是純工具庫,沒有app,於是我自己擼了一個魯班壓圖。

luban_imager.webpluban_imager.webp

功能單一,打開圖片,壓縮,保存,僅此而已。

另外推薦一下Flutter,開發安卓app很絲滑,不像ReactNative那樣各種奇怪的小問題,而且包體積很膨脹。這個app也有十幾MB了,懷念以前幾百KB的小app〜

繡球

· 閱讀需 2 分鍾

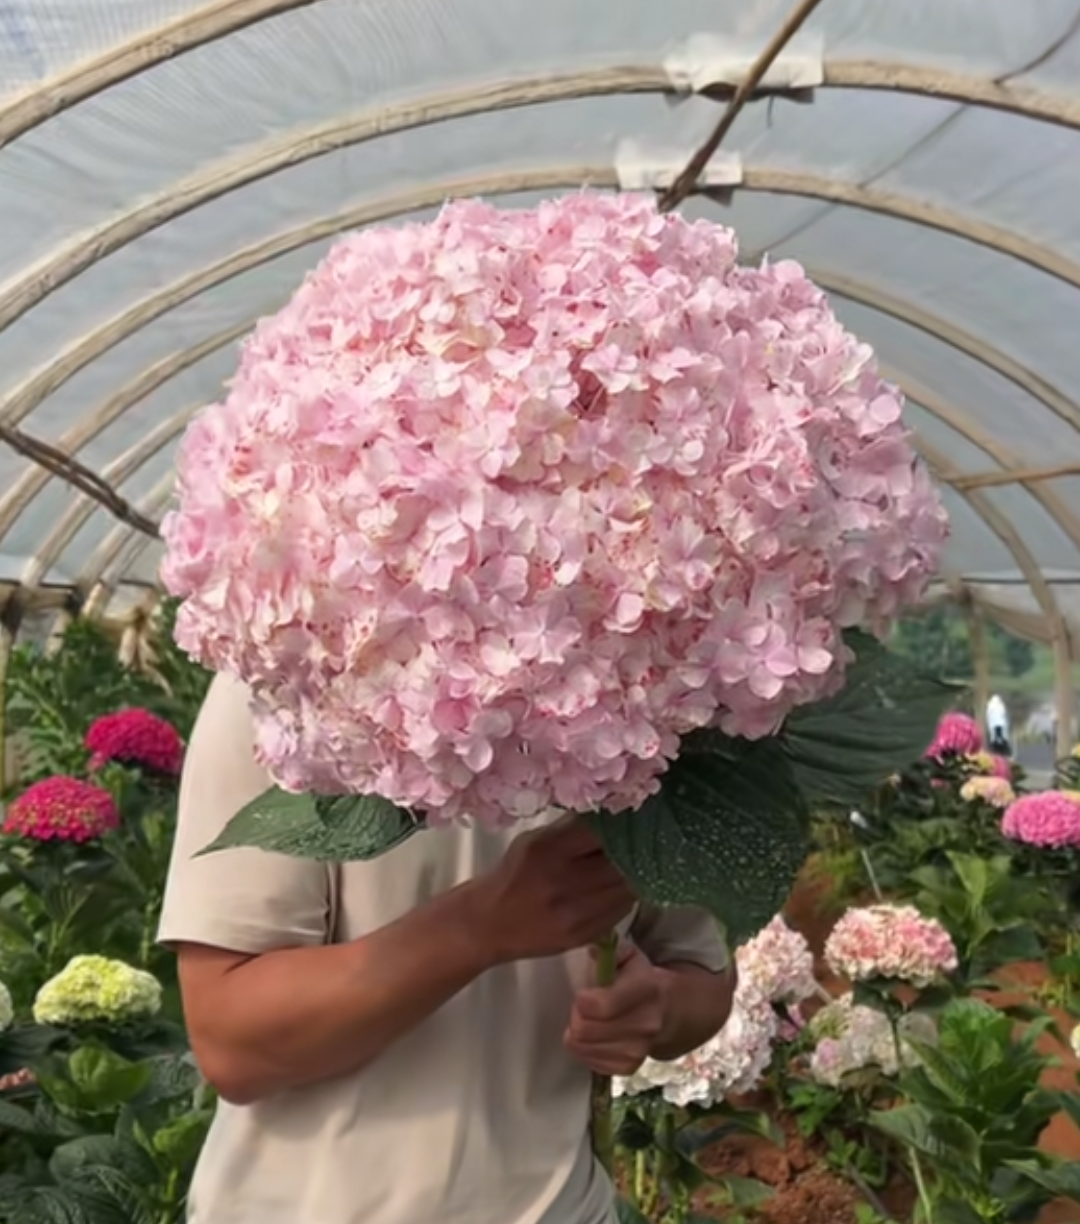
某天晚上心情不好,去公園散步。回來的時候路邊看到一個巨大的“花球”,很圓,由一朵朵小花組成。我忍不住拍了拍,很緊湊,有彈性。

後來和朋友說起,她說可能是繡球。可繡球哪有那麼大的?那朵花球一個人懷抱都抱不住。但其它方面確實很接近。她發了個視頻給我,是一株臉盆大的繡球花。盡管我看到的還要更大,但我接受了她的說法。

S60516-15501218_com.ss.android.ugc.aweme.pngS60516-15501218_com.ss.android.ugc.aweme.png

今天送貓去絕育,心裡好奇,故地重遊,再尋巨型繡球花。印象裡的路段都走遍了,卻沒有找到繡球花的蹤影。公園裡很多人跳交際舞,音樂聲嘈雜著交流聲,和夜晚的靜謐完全不一樣。我感到一陣恍惚,難道其實是在夢中遇到的?

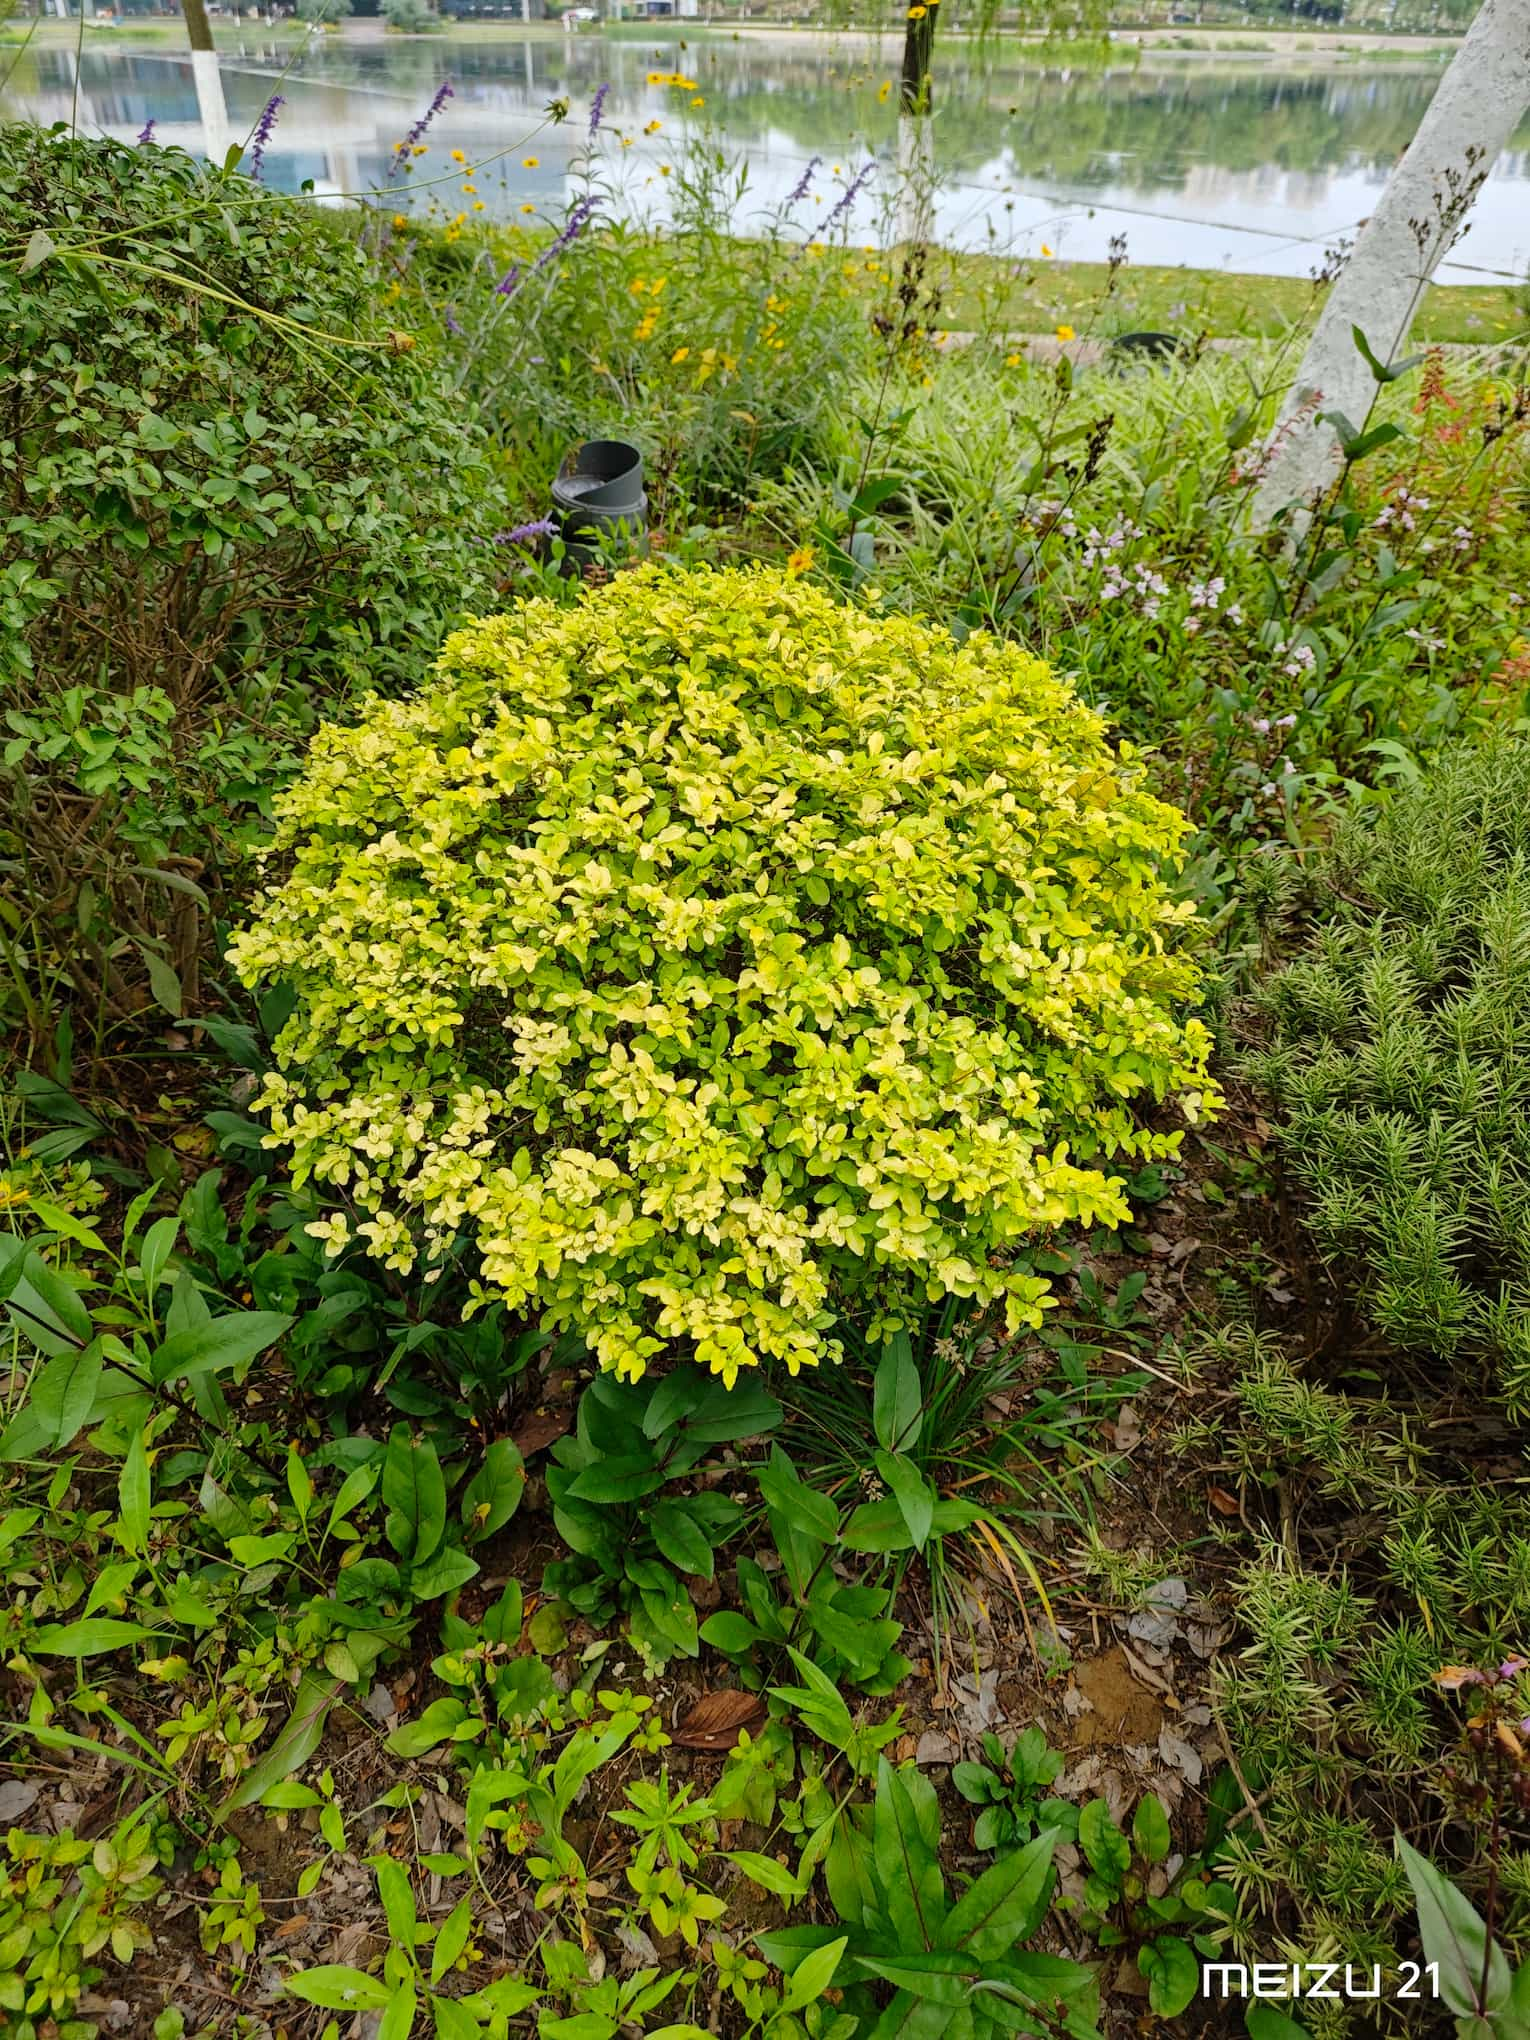
我再次搜索路邊任何球狀的植物。然後我看到了這個。

P20260516-144616.jpgP20260516-144616.jpg

我無法確定這到底是否是昔日之物,但除此之外再無球形植物。花了好一會我終於接受:我把人工修剪的灌木當成花了。

給用了9年的剃須刀換電池

· 閱讀需 2 分鍾

大學時買的飛利浦PQ190剃須刀,已經9年了,電池垂垂老矣,充滿電用一兩次就刮不動了。想重新買一個,又感覺它好好的扔了挺可惜。我為什麼不能自己換個電池呢?

想到就做,先拆開看看電池什麼樣。結構比我想象中簡單,一塊電路板,一個馬達,一塊7號充電電池。麻煩的是電池是焊在電路板上的,需要用到烙鐵。我有點猶豫,會不會太麻煩了?不過早就想玩焊接了,趁著興奮勁激情下單了電烙鐵和新電池。

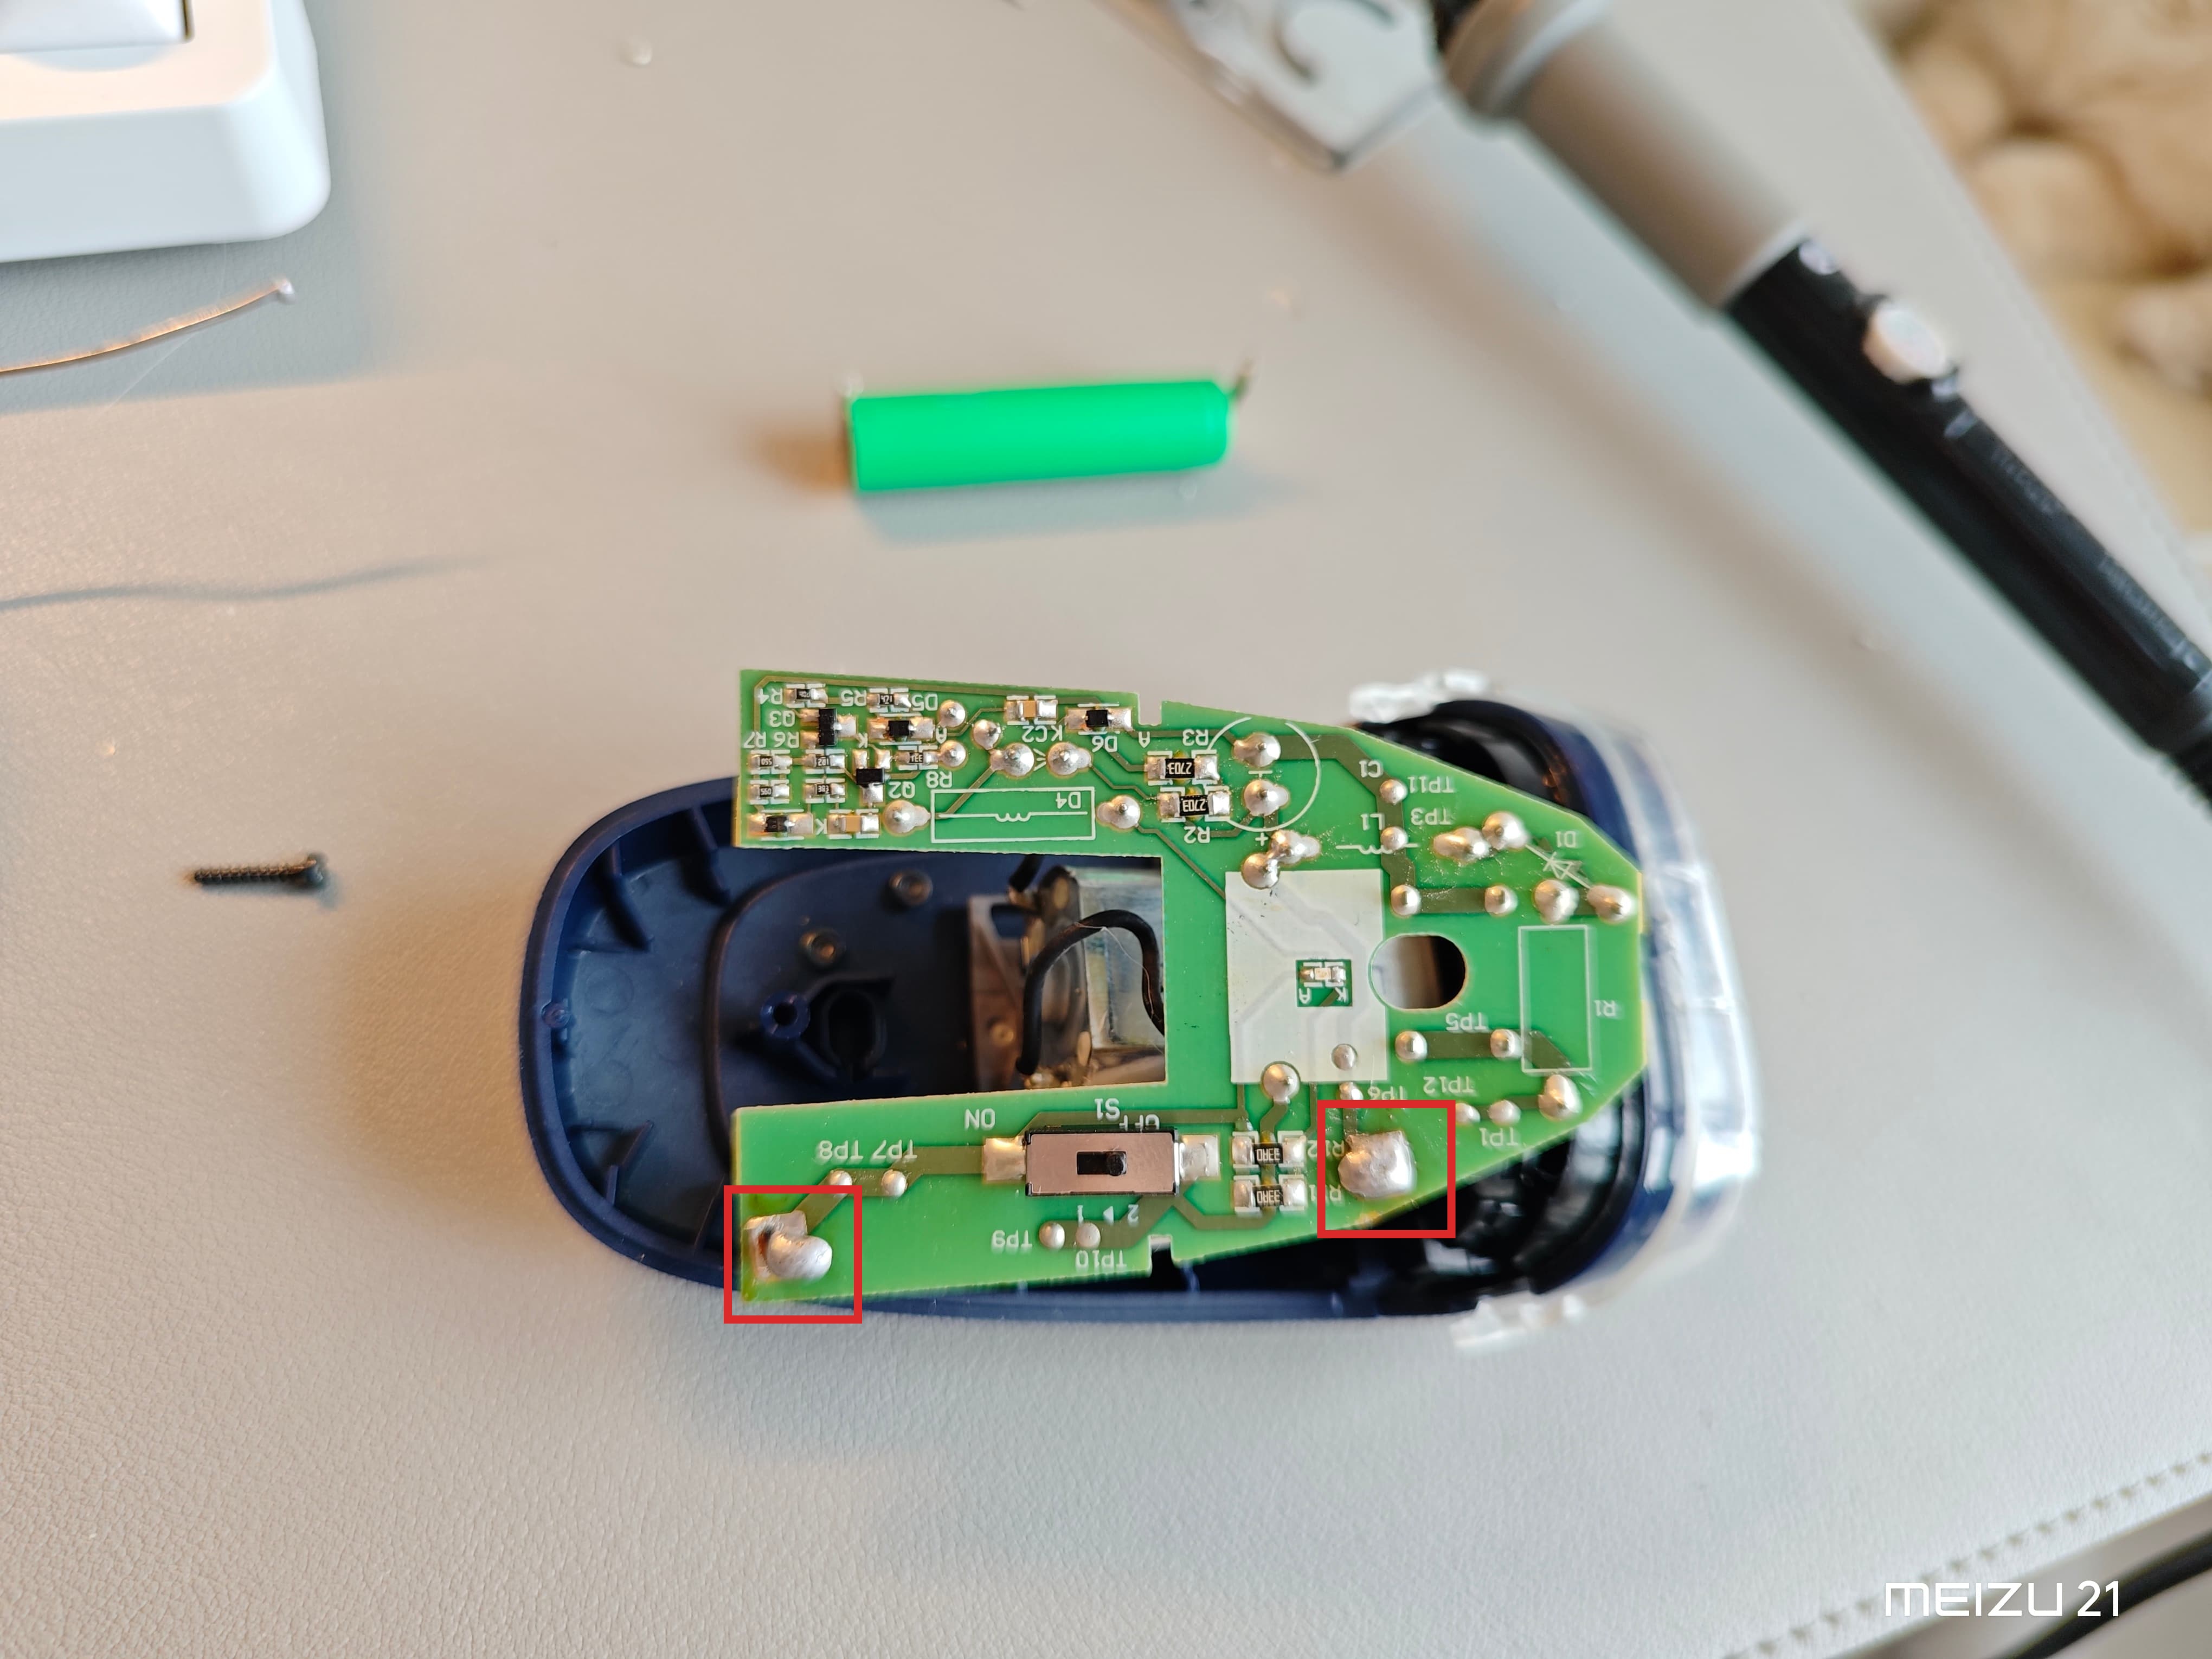
第一步是把舊電池拆下來,先用電烙鐵融掉引腳上的錫(圖是換好之後才拍的):

P20260513-153724(1).jpgP20260513-153724(1).jpg

錫真的很好融誒,但是把它弄下來好難!剛關掉烙鐵電源,它又“幹”掉了,只能靠烙鐵一點一點蹭下來,我為什麼不買吸錫器@_@

廢了九牛二虎之力,終於清理掉了老錫。又碰到新問題:新電池的電極片比舊電池寬一點!電路板上的卡槽插不進去...事已至此斷無放棄的理由,用小刀慢慢把口子磨大,總算塞進去。

最後一步是重新焊接電極片,防止松動。但此刻我的烙鐵針頭已經因為使用不當有點損壞了,針頭的一部分融不掉錫,用根部一點才成功融化錫絲。

錫絲要很靠近電極片才行!因為錫凝固得很快,前幾次錫都在錫絲上直接凝固成球了=_= 好在經過幾次失敗,最終還是成功焊住了電極片。雖然焊成一坨很醜陋啦(俗稱雞屎焊)

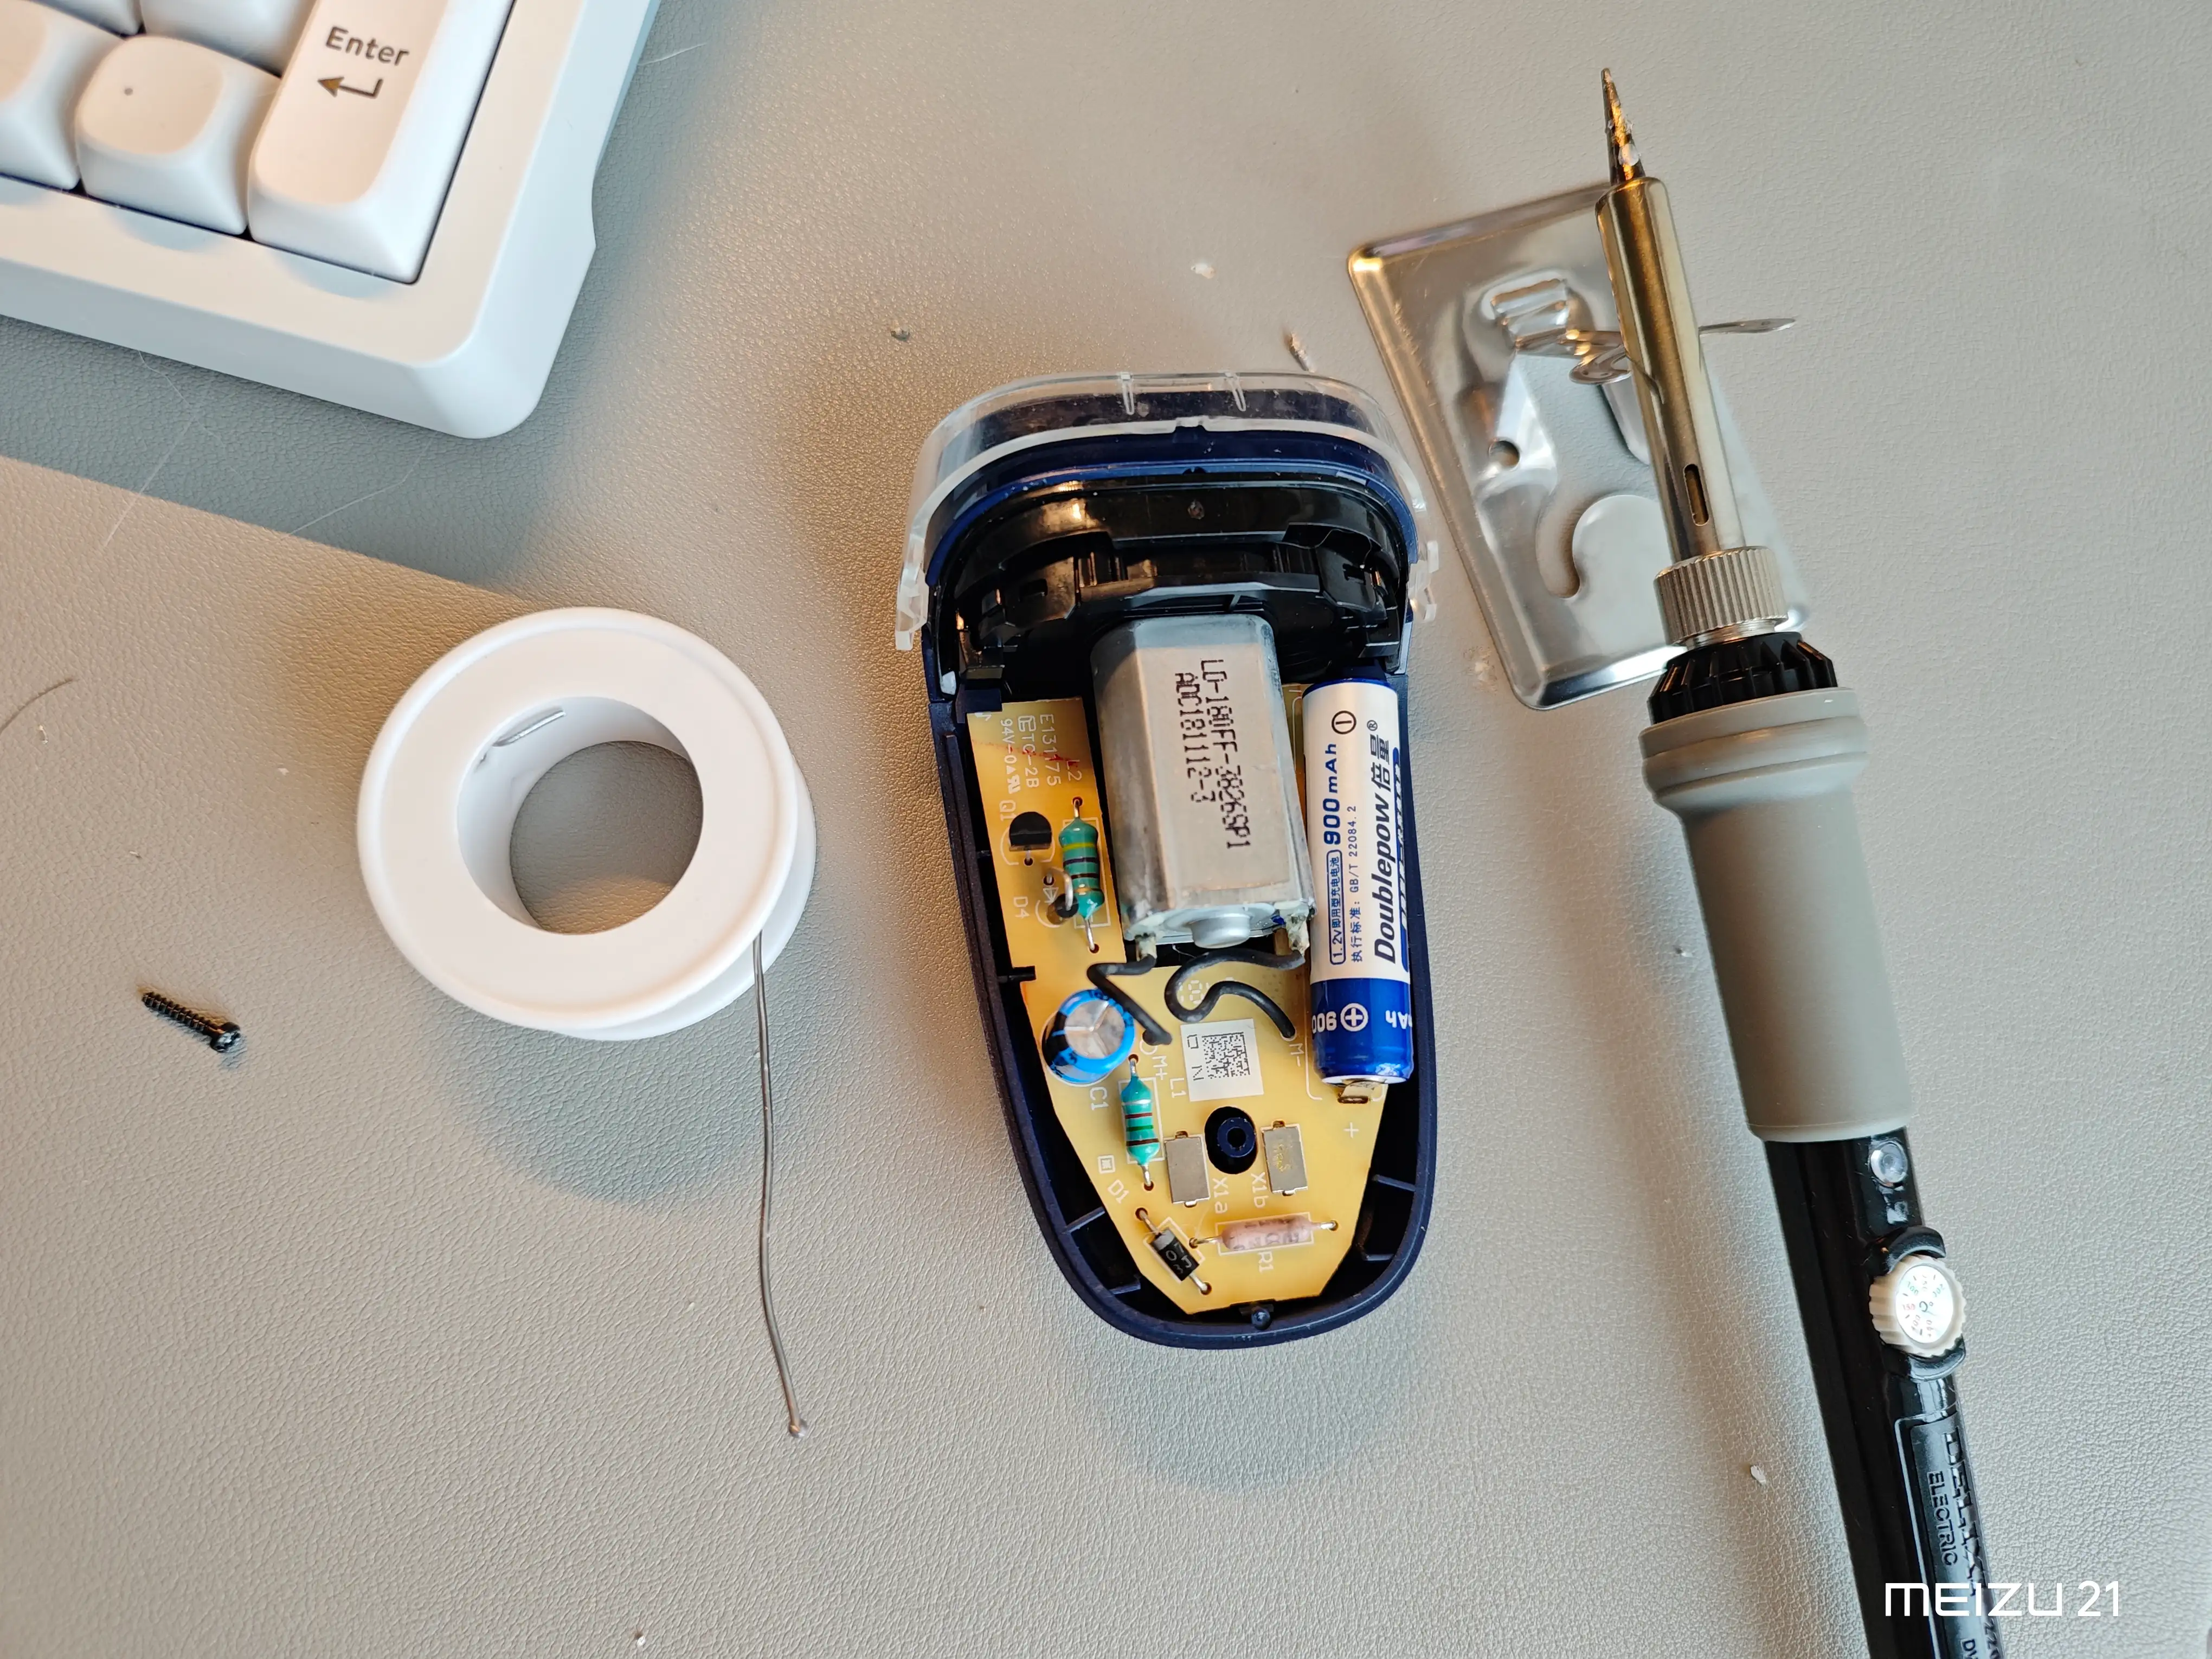
搞定收工!裝上蓋子,擰上螺絲,再戰十年!

P20260513-153823.webpP20260513-153823.webp

謹以此文紀念第一次用電烙鐵。

冰室花園

· 閱讀需 1 分鍾

終於把博客從肥大的java後端遷移到了Docusaurus靜態生成,內存佔用從幾百M降到不到10M,很是欣喜。

大學畢業後的幾年博客網站幾乎被我遺忘了,只是堅定地維持著運行。年初換了臺服務器,配置很低,博客網站被我遷移到了家裡的服務器節約寶貴的內存空間。

今年公司開始提供充足的AI報銷額度。AI帶來的生產力提升讓我熱情高漲,開始折騰集群,整理我的家庭服務器,做app,部署各種服務。博客遷移,這個在todo裡躺了幾年的待辦終於被提上日程。

遷移過程出奇的順利,AI幫我導出數據、創建新項目、生成logo,創建服務部署清單,不到半小時便替換掉了原來的Halo服務。此刻正在看假面騎士創騎,有個角色叫作冰室幻德,於是我給新的博客網站取名為:

冰室花園。

記一次誤操作刪除800G數據的經歷

· 閱讀需 4 分鍾

前因後果​

2021年2月5日,我正在嘗試運行一份示例代碼。該腳本類似這樣:

# 这里有检查$REC_ROOT,但本脚本内并未处理,所以只会输出缺少环境变量$REC_ROOT,但继续执行
./config.sh
if [ ! -d $WAV_ROOT ]; then
echo "Cannot find wav directory $WAV_ROOT"
exit 1
fi

data="$REC_ROOT/data"

# 其他代码

if [ $stage -le 0 ]; then
echo ""
echo "Stage 0: Preparing data"
rm -rf $data/*
local/chime1_prepare_data.sh || exit 1
fi

由於腳本來自知名開源項目,我並沒有仔細審查。另外由於對相關代碼並不熟悉,我也沒有正確配置相關環境變量,所以腳本中的WAV_ROOT和REC_ROOT理所當然是未定義的。

我就這麼冒失地執行了腳本,而它在打印兩句警告後並沒有停止執行,所以我認為環境變量並不是必須的,於是放任它繼續執行。由於該腳本執行的是耗時任務,我將控制臺隱藏到後臺,去完成其他任務。

過了十幾分鍾,我收到一個應用程序的崩潰報告,因為相關文件不存在。我疑惑地檢查,發現數百GB的數據已經不翼而飛。此時我才想起那個正在執行的腳本,切換過去後發現它還沒有停止執行,正在瘋狂刪除我的文件。我趕忙殺掉了腳本,但包括由於沒有root權限而刪除失敗的,原本800GB+的數據只剩5.6G。

讓我們來看看發生了什麼。

首先,腳本調用config.sh,檢測到REC_ROOT環境變量不存在並打印警告。

然後腳本繼續執行,if [ ! -d $WAV_ROOT ]; then這裡是在檢測WAV_ROOT是否是一個目錄,如果不是,就退出腳本。按理說我並沒有配置任何環境變量,此處應該退出。但bash腳本神奇地,當WAV_ROOT為空或者不存在時,這個檢測會認為這是一個目錄,從而通過檢測。即:

unset NOT_EXIST
if [ -d $NOT_EXIST ]; then
echo "this is a directory"
fi

上面的腳本是會輸出的。

或許是因為參數為空時bash默認檢測當前目錄,以至於目錄檢測總是通過。

再然後,由於REC_ROOT未定義,$data=/data,然後相當於:

rm -rf /data/*

非常不巧和不幸的是,我將一塊1TB的數據盤掛載在了/data上,於是迎來了降維打擊。該數據盤中有800G+的數據,文件量大於10萬,因此非常耐刪,過了十幾分鍾還給我剩了幾個G。而大量讀寫操作將數據恢復的難度推到了地獄級。

搶救措施​

在殺掉腳本之後,我嘗試卸載數據盤,但卸載失敗,提示正忙。情急之下我忘記了可以通過正在運行的進程恢復它們打開的文件,而是想到先關機避免更多的讀寫。關機前發現VSCodium還在運行並且有未關閉的文件,於是搶救出幾個正在編輯的代碼文件。而這成了本次事故中我唯一搶救成功的文件。

之後,通過U盤刻錄的系統修改原系統的配置,取消掉自動掛載數據盤,然後系統啟動後以只讀方式掛載數據盤嘗試恢復數據。

正如前面所說,大量的讀寫操作讓我失去了恢復的機會,嘗試了不少恢復工具,但都沒法掃描出目錄結構,唯一可能有效的方法是通過特殊的文件頭結構進行特徵掃描,但這只能恢復一些特殊格式的文件,而對我最重要的都是純文本數據,至於一些視頻文件,由於尺寸太大數據分散在不同的塊,也是基本沒戲的。

還好,雲端備份讓我不至於一無所有,但還是痛失最近一個月的活動數據和大量不可描述之物。

總結​

數據無價,謹慎操作。備份得當,也別太浪。

DOM更新與瀏覽器事件循環

· 閱讀需 5 分鍾

通常我們說DOM更新發生在一個宏任務執行完之後,但並不是每次宏任務執行後都會進行DOM更新。瀏覽器會維護一個相對穩定的幀率,根據硬件條件和頁面性能表現。那麼事件循環如何判斷是否應該更新DOM呢?

先上一波HTML規範指定的事件循環處理章程:

  1. 從事件循環的任務隊列中取一個任務隊列taskQueue,這裡的任務隊列指的是宏任務隊列。注意,一個事件循環可能並不只有一個宏任務隊列。具體有哪些以及這裡怎麼選由用戶代理決定。
  2. taskQueue中出隊一個(宏)任務oldestTask,並設置事件循環的當前執行的任務為taskQueue。
  3. 執行taskQueue。
  4. 設置事件循環的當前執行的任務為null。
  5. 執行微任務隊列中的(task)。
  6. 處理DOM更新。

上面的描述省略了一些步驟,完整版參考規範。注意worker環境的事件循環不在本文討論範疇之內。

可以發現DOM更新確實發生在兩個宏任務執行之間,但如果我們深入DOM更新步驟,會發現還有個渲染機會(rendering opportunity)的概念。DOM更新時會忽略沒有渲染機會的文檔。

那麼什麼時候一個DOM文檔(準確說是其瀏覽上下文)擁有渲染機會呢?前面說過,瀏覽器會維護一個相對穩定的幀率,例如30fps,那麼1秒內應該最多擁有30次渲染機會。瀏覽器根據這些條件和是否有DOM更新(DOM操作,動畫等),決定文檔是否應該擁有渲染機會。相對穩定的意思是,當硬件條件或者頁面性能導致無法維持較高幀率時可能會降幀。雖然這並不是規範規定的,但規範中以此為例,而且主流瀏覽器應該都是這麼實現的。

了解這些有什麼用呢?我們可以更精細地把握自己的代碼。考慮以下代碼:

setTimeout(() => {
//依赖DOM的操作
}, 0);

我們可能會用定時器來等待dom更新後執行一些操作,因為定時器創建宏任務,而DOM會在當前宏任務執行結束後更新(錯誤)。
有趣的是,這往往也不會出大問題。一來一般這時候已經執行了不少代碼,可能正好瀏覽器在當前宏任務執行完後更新了DOM,二來DOM操作往往會導致DOM強制更新(如讀取DOM元素幾何相關的數值等,但不絕對觸發強制更新),也可能會得到想要的結果。
然後結果是,bug若有若無的,全看人品。啊,我測試的時候好好的,演示的時候怎麼就...😅

上面的例子不夠具體,來個更實際的。假設要實現一個DOM元素從遠處飛回來的動畫,我們不用css animation,用transform。
首先我們需要給DOM元素一個初始偏移量,否則起點就是終點,就沒有動畫效果了。然後給它設置transition樣式,並把偏移量還原。

// 获取DOM元素,这里getElement函数未实现
const el = getElement();
// 初始偏移量
el.style.transform = 'translateX(-100px)';
// ...???
el.style.transition = 'transform 100ms linear';
el.style.transform = 'translateX(0)';

為了讓動畫從初始偏移量開始,我們需要在???前後代碼執行之間觸發一次DOM更新。

最簡單的就是觸發DOM強制更新。

// 获取DOM元素,这里getElement函数未实现
const el = getElement();
// 初始偏移量
el.style.transform = 'translateX(-100px)';
el.getBoundingClientRect();
el.style.transition = 'transform 100ms linear';
el.style.transform = 'translateX(0)';

通過getBoundingClientRect()讀取元素的幾何信息,迫使DOM重新計算元素的屬性。但這可能造成額外的運算,帶來性能損失。雖然一般場景下問題不大。

如果我們想將???後面的代碼延遲到下一幀之後執行呢?靠setTimeout()的話,timeout設置小了就回到bug與人品的故事了,設置大了又會產生卡頓影響體驗。這時候我們可以通過一個神奇的API來解決:requestAnimationFrame。

// 获取DOM元素,这里getElement函数未实现
const el = getElement();
// 初始偏移量
el.style.transform = 'translateX(-100px)';
requestAnimationFrame(() => {
setTimeout(() => {
el.style.transition = 'transform 100ms linear';
el.style.transform = 'translateX(0)';
}, 0);
});

首先,requestAnimationFrame()的回調會在下一幀繪制之前執行。我的理解是,執行requestAnimationFrame的回調函數列表作為一個宏任務被調度,並且此時該DOM文檔獲得渲染機會,因此回調執行結束後DOM將更新,而當回調函數中設置的定時器任務被執行的時候已經處於新的宏任務中,此時DOM文檔已更新。

注意:對於處理一個瀏覽上下文的requestAnimationFrame回調時的宏任務和下一個宏任務之間,該瀏覽上下文一定獲得會渲染機會是否成立,尚未找到規範證明,僅作參考。

本文鏈接:https://blog.mattuy.top/archives/dom-update-and-browser-event-loop

LeetCode之旅──696.計數二進制子串

· 閱讀需 2 分鍾

題目:給定一個字符串 s,計算具有相同數量0和1的非空(連續)子字符串的數量,並且這些子字符串中的所有0和所有1都是組合在一起的。
重復出現的子串要計算它們出現的次數。

示例:

輸入: "00110011"
輸出: 6
解釋: 有6個子串具有相同數量的連續1和0:“0011”,“01”,“1100”,“10”,“0011” 和 “01”。

請注意,一些重復出現的子串要計算它們出現的次數。

另外,“00110011”不是有效的子串,因為所有的0(和1)沒有組合在一起。

最先想用棧來解決,但發現行不通。然後慢慢發現規律了,我們可以用一個指針對準第一個數字的起點(最先是0),然後用另一個指針對準另一個數字的起點(如示例中第一個1的位置),然後兩個指針一起跑,只要它們對應位置的值不相等,那答案就加1。值相等後必然是其中一個數字跑完了,可以根據和前一個位置對比得出是跑在前面的指針跑完了還是跑在後面的,如果是前面的先跑完了就讓後面的指針直接跑到下一個起點(即前面的指針本次的起點),接著開始下一輪,直到有一個指針到達末尾。

好吧上面一段其實並不用看,我們只需要將相同的數字看作一組,然後遍歷每組的數字個數組成的數組,相鄰元素取最小值,加起來就得到結果了。比如示例的數組為[2, 2, 2, 2],相鄰取最小再加起來就是6。

其實理論上說兩個方法是差不多的,後者像是前者的抽象化。我們刷算法題總是容易下意識的用人類思維思考,然後用計算機去“模擬”,所以經常會遇到將思維轉化為代碼時不流暢和容易出錯。我認為所謂算法思想,就是一種將人類思維抽象成計算機思維的能力。

當絕對定位遇上層疊上下文

· 閱讀需 3 分鍾

css中position: absolute可以將元素指定為絕對定位,那麼絕對定位元素的幾何位置是相對於誰計算呢?

MDN上的描述是:

絕對定位元素相對於最近的非 static 祖先元素定位。當這樣的祖先元素不存在時,則相對於ICB(inital container block, 初始包含塊)。

也即是說,絕對定位元素應該相對其position為非static的最近祖先定位,或者這樣的祖先不存在時相對初始包含快(一般為body)定位。而position默認為static。

但似乎有時候也有例外。

今天想在一個scroller組件中使用絕對定位突破到更頂層,但意外的發現,即使從該元素的父元素到body都沒有指定position屬性,它竟然仍是相對scroller容器定位而不是body或者更上層的具有position: relative屬性的元素。

實驗了半天發現是因為scroller使用了css的transform屬性來變換滾動元素的位置以提升性能。而這直接導致了具有有效transform屬性的元素成了絕對定位元素的基準。

考慮如下html:

<div style="line-height: 50px;">
<style>
.relative-container {
background: lightcoral;
position: relative;
height: 300px;
}
.midware {
background: lightcyan;
height: 200px;
}
.absolute-block {
background: black;
height: 30px;
position: absolute;
top: 0;
width: 30px;
}
</style>
<div class="relative-container">
------把下面的div撑下去一点方便观察差异-------
<div class="midware">
<div class="absolute-block"></div>
</div>
</div>
</div>
------把下面的div撐下去一點-------

如上,absolute-block成功突破了midware,top: 0是相對於relative-container而不是其直接父元素midware。但是當我們為midware添加transform屬性後:

.midware {
background: lightcyan;
height: 200px;
transform: translateZ(0);
}
------把下面的div撐下去一點-------

absolute-block已經相對其父元素midware定位了!但midware的position並沒有被顯示指定。transform設置為其他有效值效果也一樣。

為了測試transform屬性是否隱式改變了position屬性,我添加了如下代碼:

const el = document.querySelector('.midware');
console.log(getComputedStyle(el).position); // static

並沒有。這個現象應該是由其他機制引起的。

最後查了下資料,有人說是由層疊上下文導致的。但又不是所有的層疊上下文都會造成這樣的影響,不同內核的瀏覽器也有不同的表現。所以應該將這個特性當作bug來對待?

參考:
不受控制的 position:fixed

JS省略分號導致的災難

· 閱讀需 4 分鍾

挺長一段時間在糾結寫JavaScript代碼要不要打分號。這是一個個人風格問題,以下觀點僅代表個人喜好。

不要省略分號!不要省略分號!不要省略分號!

雖然js引擎執行代碼時會自動插入分號,但有些時候省略分號可能導致一些隱蔽的問題。

return語句​

return後面會被自動插入分號,所以下面的代碼返回undefined而不是一個字符串。

function foo() {
return
"this will return undefined"
}

當然,這完全可以避免,我們可以將返回值寫在一行或者用括號包起來。

function foo() {
return (
"this is ok."
)
}

似乎這點也不是不省略分號就能避免的,如果您不清楚這條規則,下面的代碼可能會帶來疑惑:

function foo() {
return
'a long expresion' +
'another long expresion';
}
foo(); // undefined

OK,這不是重點,事實上現代編輯器足夠聰明,這樣的情況應該會將return後面的語句給你標注為灰色,你很容易就可以看到它們沒有正確的被執行。這裡只是順帶一提。我們來看更隱蔽的坑。

函數執行​

考慮下面的代碼:

var foo = 0
var bar = 1

foobar()

('some condition' && 'another condition') ? foo = -1 : bar = -1

console.log(foo, bar)

function foobar() {
return function () { return false }
}

請問上面的代碼輸出什麼?答案是0 -1

我們的本意是在兩個條件滿足時給foo變量賦值-1,否則給bar變量賦值-1。這裡本該輸出-1 1,但由於語句以括號開頭,js執行引擎誤以為上一行的語句還沒有結束,正好foobar()返回了一個函數,於是上面的代碼相當於(為了更清晰我引入了一個變量):

var condition = foobar()('some condition' && 'another condition');
condition ? foo = -1 : bar = -1;

foobar()返回的函數總是返回false,所以被賦值的總是bar變量,這完全改變了我們的初衷!而且編輯器不會有提示:沒有語法錯誤。甚至運行時也不會直接出錯,而是在某個case下才命中bug。

解構賦值​

接下來是我今天親身經歷的的場景。

ES2015(ES6)新增了一個解構賦值的特性,用於交換兩個變量的值那是非常的方便。例如交換a,b變量的值:[a, b] = [b, a]。當然解構賦值還有很多其他特性,可以參考MDN。

考慮如下代碼:

var m = n = 0;
var swap = -1;
var matrix = [
[1, 2],
[3, 4]
];

//do something...

[matrix[m][n], swap] = [swap, matrix[m][n]]
[m, n] = [n, m]

console.log(matrix) // [[0, 2], [3, 4]]

OK,我們不用管代碼是要做什麼,反正就是想交換matrix[m][n]和swap的值,再交換m和n。期望的輸出應該是[[-1, 2], [3, 4]]。然鵝...

事實上在寫這篇博客之前我是贊成省略分號的。前面兩種情況我都習慣性會注意避免,也沒出過類似的錯誤。但終於還是不留神栽在了解構賦值上。

還是解釋一下,上面的解構賦值語句等價於:

[matrix[m][n], swap] = [swap, matrix[m][n]][m, n] = [n, m]

//不太清晰?由于m == n == 0,逗号表达式m,n的值为0,所以再等价于:
[matrix[m][n], swap] = [swap, matrix[m][n]] [0] = [n, m]
//即
[matrix[m][n], swap] = swap = [n, m]
//即
[matrix[m][n], swap] = [n, m]
//即
maxtrix[0][0] = 0;
swap = 0;

同樣,由於沒有語法錯誤,IDE同樣不會檢測到。

總結​

暫時沒有遇到其他情況,不過有時候是防不勝防。咱一朝被蛇咬,十年怕井繩。添上分號他不香嘛。

webpack模塊加載機制

· 閱讀需 8 分鍾

前端項目的規模越來越龐大,模塊化開發已經是普遍需求。早期的打包工具將所有模塊化的代碼打包到一個bundle文件中,在一個簡單的html文件中引入腳本。webpack允許輸出為多個bundle文件,從而實現按需加載,更好的利用瀏覽器緩存,提升用戶體驗。

這裡不討論如何配置webpack,只說webpack如何加載模塊。考慮一個多頁面程序,有page1和page2兩個頁面,都用到一個工具模塊util,page1直接引用util,而page2在頁面加載後滿足一定條件時動態加載util。

//util.js
console.log('util')
export function log(arg) {
console.log(arg)
}
//page1.js
import { log } from './util'
//...
log('page1')
//page2.js
//...
//条件满足时动态加载util
import('./util').then((util) => {
util.log('page2')
})

首先明確webpack中的兩個概念:

  • module:一般是源代碼中的一個文件,打包後被包裹在一個函數中,webpack模擬了模塊環境
  • chunk:一個chunk即一個輸出bundle文件,不考慮其它分割規則,每個入口將產出一個chunk。一個chunk包含若幹module

假設我們已經配置好webpack,讓它輸出三個chunk:

0.js //util.js
page1.js //页面1
page2.js //页面2

下面從webpack的打包輸出來分析webpack模塊加載機制。

靜態依賴​

webpack中,一個js源文件作為一個模塊(也可以是其他文件)。webpack將模塊代碼包裹在一個函數中,返回模塊的導出內容。注意,每個模塊最多僅被執行一次,第二次請求時會直接從緩存返回。

(打包後的)page1.js:

//立即执行函数初始化webpack运行时,然后加载入口模块
(function (modules) {
//modules是被打包到page1.js这个文件(chunk)中的模块列表,此处有page1和util两个模块
//已加载的模块的缓存
var installedModules = {};
// webpack require函数,用来加载模块
function __webpack_require__(moduleId) {
//检查模块是否已装载,是则返回缓存的模块
if (installedModules[moduleId]) {
return installedModules[moduleId].exports;
}
//将模块添加到缓存
var module = installedModules[moduleId] = {
i: moduleId, //模块ID
l: false, //模块是否已装载
exports: {} //模块的导出内容
};
// 执行模块初始化
modules[moduleId].call(
module.exports, //将模块代码的this指向其自己的exports
module, //相当于commonjs中的module,对模块自身的引用
module.exports, //相当于commonjs中的exports,模块的导出内容
__webpack_require__ //相当于commonjs中的require,提供加载同一chunk中其他模块的方法
);
// 将模块标识为已加载
module.l = true;
// 返回模块的导出内容
return module.exports;
}

//加载入口模块,即我们的page1.js
return __webpack_require__(__webpack_require__.s = "./src/page1.js");
})({
//page1模块
"./src/page1.js":
function (module, __webpack_exports__, __webpack_require__) {
let util = __webpack_require__('./src/util.js')
util.log('page1')
},

//util模块
"./src/util.js":
function (module, __webpack_exports__, __webpack_require__) {
function log (arg) {
console.log(arg)
}
//util模块导出log函数
__webpack_exports__['log'] = log
}
});

代碼被我簡化了一下,webpack有很多兼容性和安全性方面的考慮,我將那部分修改了讓代碼看起來清晰。

可以看到,util和page1被函數包圍,模擬模塊環境,然後作為參數傳遞給立即執行函數。注意,模塊只有被加載時才會執行內部代碼。

在立即執行函數中,先進行了webpack初始化,即提供核心的模塊加載函數__webpack_require__函數,並在函數上配置一些靜態字段記錄必要的信息(如__webpack_require__.s為入口模塊ID),然後裝入入口模塊,開始執行我們自己的邏輯代碼。

按需加載​

在page2中我們使用了動態import()方法來加載util模塊。webpack足夠智能,無需配置它也聰明的自動將util獨立到單獨的文件(chunk),在需要時再進行請求。

webpack通過jsonp機制加載不同chunk中的模塊。

page2.js:

(function(modules) {
//模块加载函数,同page1。注意,此函数仅用于加载已被
function __webpack_require__(moduleId) {
//......
}

//可用的模块列表,包含本chunk中的模块和已经请求完毕的,来自其他chunk的模块
__webpack_require__.m = modules;
//基路径,用于拼接其他chunk的url
__webpack_require__.p = "";
//已装载的模块缓存,注意区分__webpack_require__.m,前者应该是后者的子集
var installedModules = {};
//这是相对page1中多出来的东西,用来记录其他chunk的加载情况
//值可能有3种:
// undefined, 即该chunk还没有被请求过
// 0, 该chunk中的模块已经正确的添加到__webpack_require__.m中,可以通过__webpack_require__加载了
// [resolve, reject, promise], chunk正在请求中。promise在chunk请求结束后才被resolve或reject
var installedChunks = {
"page2": 0 //page2即页面2的chunk自身,当然已经加载完成
};

//jsonp函数,chunk请求成功时由被请求的chunk调用。它的任务为将chunk中的模块加入可用模块列表
//data参数由被请求的chunk传过来,包含模块信息。这也是jsonp的核心部分
function webpackJsonpCallback(data) {
var chunkIds = data[0];
var moreModules = data[1];
var moduleId, chunkId, i = 0, resolves = [];
for(;i < chunkIds.length; i++) {
chunkId = chunkIds[i];
if(Object.prototype.hasOwnProperty.call(installedChunks, chunkId) && installedChunks[chunkId]) {
resolves.push(installedChunks[chunkId][0]);
}
//表示chunk已经加载好啦,下次不用去请求了
installedChunks[chunkId] = 0;
}
for(moduleId in moreModules) {
if(Object.prototype.hasOwnProperty.call(moreModules, moduleId)) {
//把chunk中的模块们加入可用列表(__webpack_require__.m == modules √)
modules[moduleId] = moreModules[moduleId];
}
}
//原数组的push函数,详见后文
if(parentJsonpFunction) parentJsonpFunction(data);
//resolve请求时创建的promise,执行回调
while(resolves.length) {
resolves.shift()();
}
};

//异步请求chunk
__webpack_require__.e = function requireEnsure(chunkId) {
var promises = [];
var installedChunkData = installedChunks[chunkId];
//检查chunk是否已经加载。0表示已加载
if(installedChunkData !== 0) {
//正在加载...有点不清楚为啥要重复记录一次promise?
if(installedChunkData) {
//installedChunkData[2]是之前请求的promise
promises.push(installedChunkData[2]);
} else {
//没有请求过,开始请求chunk
//标识chunkId这个chunk正在请求,并记录promise相关信息
var promise = new Promise(function(resolve, reject) {
installedChunkData = installedChunks[chunkId] = [resolve, reject];
});
promises.push(installedChunkData[2] = promise);
//现在installedChunks[chunkId] = [resolve, reject, promise]了
//用script标签加载chunk
var script = document.createElement('script');
var onScriptComplete;
script.charset = 'utf-8';
script.timeout = 120;
script.src = jsonpScriptSrc(chunkId);
//...请求错误处理...省略
//...超时处理
var timeout = setTimeout(function(){
}, 120000);
document.head.appendChild(script);
}
}
return Promise.all(promises);
};

//拼接被请求chunk的url
function jsonpScriptSrc(chunkId) {
return __webpack_require__.p + "" + ({}[chunkId]||chunkId) + ".js"
}
//通过window.webpackJsonp数组记录加载成功的chunk数据。其他chunk被加载后会将自己的chunk数据push到这个数组
var jsonpArray = window["webpackJsonp"] = window["webpackJsonp"] || [];
//注意,webpack覆盖了window.webpackJsonp数组的push函数。将原生的push函数替换成了webpackJsonpCallback
//在webpackJsonpCallback函数中我们看到有调用parentJsonpFunction,其实那个函数才是原来的数组的push函数
var oldJsonpFunction = jsonpArray.push.bind(jsonpArray);
jsonpArray.push = webpackJsonpCallback;
//理论上说这时jsonpArray应该是空的。。但如果不是空的就手动调用下webpackJsonpCallback装载chunk
//window["webpackJsonp"]已经被webpack污染啦,所以它复制了一下?
jsonpArray = jsonpArray.slice();
for(var i = 0; i < jsonpArray.length; i++) webpackJsonpCallback(jsonpArray[i]);
var parentJsonpFunction = oldJsonpFunction;

//加载入口模块
return __webpack_require__(__webpack_require__.s = "./src/page2.js");
})
({
//页面2
"./src/page2.js":
(function(module, exports, __webpack_require__) {
//我们的动态import()被webpack转化后大致代码
//先请求包含util的chunk
__webpack_require__.e(0)
//请求成功之后通过__webpack_require__加载util模块
.then(__webpack_require__.bind(null, 0))
//执行我们自己的逻辑代码
.then((util) => {
util.log('page2')
})
})
});
代碼仍然有點長,不過已經刪除和修改了很多邊緣代碼,並且調整了一下順序,結構比較清晰了。代碼中的注釋解釋了整個模塊加載過程。先通過jsonp請求得到chunk數據,然後緩存chunk中的模塊到可用列表(未裝載),這時同步的模塊加載已經可用,直接調用__webpack_require__加載相關模塊,步驟就和page1一樣了。

被加載的chunk結構就很簡單了,只是簡單的調用jsonp函數傳入模塊數據。

//0.js

//注意,前面说了,window["webpackJsonp"]数组的push函数被webpack重写了
//所以实际上这里调用了主模块那边定义的webpackJsonpCallback函数
//一个chunk可能包含多个模块,所以参数为 [moduleIds],moreModules
(window["webpackJsonp"] = window["webpackJsonp"] || []).push([[0], {
"./src/util.js":
(function (module, __webpack_exports__, __webpack_require__) {
"use strict";
__webpack_exports__['log'] = function (arg) {
console.log(arg)
}
})
}]);

總結​

當項目規模增長到一定程度,模塊化已是剛需。在ESModule標準制定之前廣泛使用的模塊化標準有commonjs,AMD,以及綜合兩者的UMD等。在ES6中模塊化終於得到標準的支持,然而各平臺對其的支持有限,暫時還難以替代傳統解決方案。萬幸,webpack提供了綜合各種模塊化標準的機制,讓我們能夠平穩的過渡。